PgSteward: 台数にもテナント数にも縛られない PostgreSQL コネクションプーラー
近年、データベースを作成・管理する主体は人間から AI agent に移りつつある。 Databricks の Lakebase の論文1によると、Lakebase では 1 日あたり 1,000 万を超えるデータベースが作成・管理されていて、AI agent が作るデータベースの数は人間の約 4 倍に達しているという。 この規模になると、データベースまわりの設定を人間が 1 つずつ見直していく運用は成り立たない。 コネクションプーラーもその例外ではなく、既存のプーラーでは、プーラーの台数やテナント2が増えるたびに人間がプールサイズを見直している。
そこで、複数のプーラーのプールサイズを 1 箇所の台帳でまとめて管理し、需要に応じて自動で払い出すコネクションプーラー PgSteward を作った。 この記事では、既存のプーラーで何が足りないのかと、PgSteward が何を実現するのかを説明する。
donkomura/PgSteward A PostgreSQL connection pooler whose pool size is a budget, not a setting. github.com/donkomura/PgSteward既存のコネクションプーラーで何が足りないのか
PostgreSQL は接続 1 本ごとにプロセスを作り、受け入れる本数の上限を max_connections で決めている。 そのためアプリケーションが増えると接続の合計はすぐにこの上限に近づいてしまう。 そこで、アプリケーションとデータベースの間にコネクションプーラーを置き、少数の接続を使い回すのが一般的である。 PostgreSQL 向けのプーラーとしては PgBouncer が広く使われていて、マルチコア対応やシャーディングを足した PgCat や、クラウドで大量のクライアント接続を捌く Supavisor もある。
これらのプーラーでは、PgBouncer が登場した 2007 年から今日まで、プールサイズの上限は設定ファイルに書く静的な値として扱われてきた。 しかし、固定値の上限は、台数・テナント数・需要のいずれかが変わるたびに実態と合わなくなってしまう。 以下では、それが問題になる場面を 3 つ挙げる。
プーラーの台数が変わる
プーラーはクライアントとDBサーバー間の通信において単一障害点になるので、冗長化のために最低でも 2〜3 台は並べて冗長化しておきたい。 アプリケーションと同じホストに同居させる構成なら、アプリケーションが 10 台から 50 台にオートスケールすればプーラーも 50 台になる。 ところが、既存のプーラーにはクラスタ全体のプールサーバーの台数の合計を書く場所がない(pgbouncer#103)ので、人間が max_connections を台数で割って 1 台あたりの上限を決める必要がある。 この場合、台数が増えたときにこの値を書き換えなければ、データベースへの接続の合計は台数に比例して増え、max_connections を超えて接続エラーになってしまう。 逆に安全側に小さく書けば、データベースに余裕があっても並行度が落ちてしまう。
また、台数が固定であっても、割り算で決めた値は需要の偏りに合わない。 例えば、ロードバランサの偏りで 1 台に需要が集中すると、その 1 台は上限に達してクライアントが待たされる一方で、他のノードでは枠が遊んでしまうので公平な負荷分散にならない。
テナントの需要が混雑時にぶつかる
PgBouncer は接続先データベースと接続ユーザーの組ごとにプールを分けるので、マルチテナントな SaaS ではテナントの数だけプールができる。 その中には、夜間バッチやプロモーションで急にコネクションを大量に消費するテナントが含まれる。 このとき、合計の上限だけを決めて先着順で使わせると、こうしたテナントが空きを取り切ったときに、他のテナントへ接続が回らなくなる。 実際に、1 つのデータベースへの接続数の合計を制限する設定 max_db_connections = 10 をユーザー A / B / C で共有して同じ負荷をかけると、A だけが接続を取れて C はタイムアウトを繰り返すという挙動が報告されている(pgbouncer#131)。 特に、トランザクションが数秒かかるバッチと数ミリ秒で終わるオンライン API を同じキューに並べると、接続はバッチ側に滞留し、API の応答時間はバッチのトランザクションの長さまで伸びてしまう。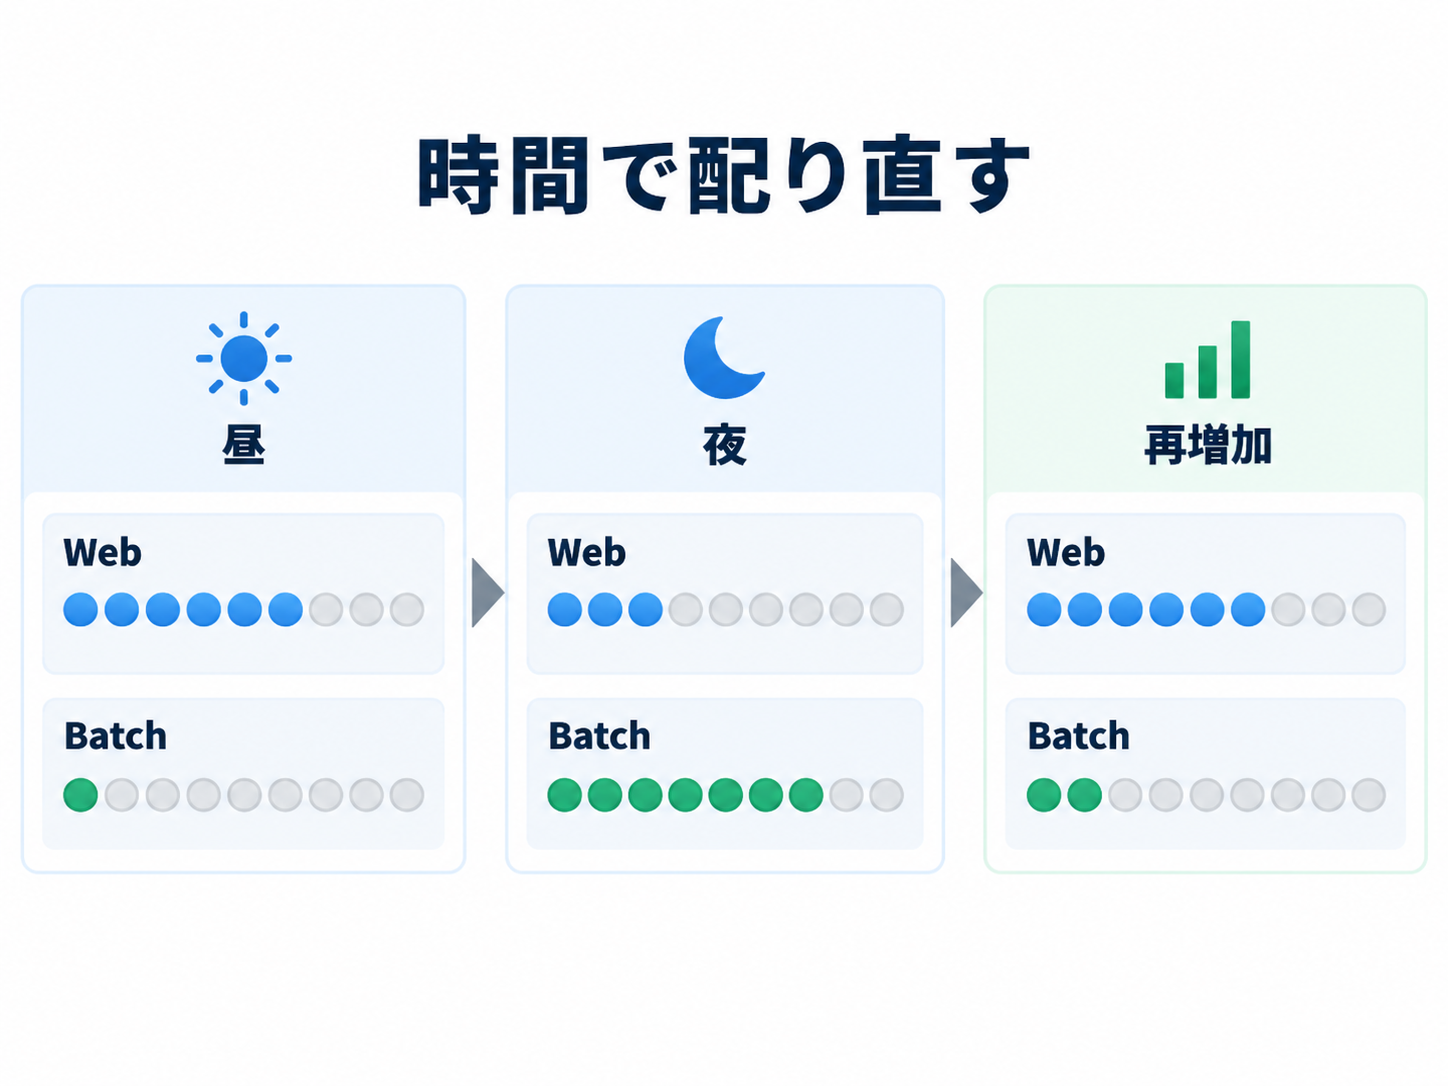
一方で、テナントごとに固定サイズで分ければ下限は守れるが、今度は需要のないテナントの枠が遊んでしまう。 また PgBouncer は、使われなくなったテナントのプールを管理用の情報として持ち続けるので、テナントが増え続ける環境ではこの情報も増え続けてしまう。
プーラー以外の接続元
データベースには、プーラー以外にも管理者の作業や監視が接続する。 そのため、プーラーが max_connections まで使い切ると、これらの接続元はデータベースに接続できなくなる。 一方で、1 本あたり数 MB のメモリを消費するコネクションを遊ばせておくのも無駄である。 プーラーの接続の合計は、他の接続元のぶんを残したうえでできるだけ使い切りたい。 これを固定値で実現しようとすると、ノードが追加された際には他の接続元のぶんも含めて人間が割り算をやり直す必要があるが、この方法ではコネクションプーラーを運用しずらい。
求められる性質
ここまでの問題を、新しいプーラーに求める性質として整理し直すと次の 4 つになる。
- 管理者や監視など他の接続元を締め出さない
- API とバッチのように用途を分けたとき、各用途が確保できる接続数の下限を保証する
- 空いたコネクションを遊ばせない
- クエリの経路にホップを増やさない
しかもこれらを、プーラーの台数やテナント数が変わっても、設定を書き換えずに満たしたい。 この観点で既存の方式を見ると、固定サイズで分ける方式は下限を保証できるが、空きが遊んでしまう。 反対に、合計だけを決めて先着順で使わせる方式は空きが遊ばないが、下限がない。 これらとは別の方式として、Supavisor はテナントごとに接続を担当するノード(所有ノード)を 1 つ決めて接続を集約するので、台数を増やしても接続は増えないが、所有ノードへの中継が挟まるぶん、すべてのクエリに 1 ホップ分の遅延が加わる。 このように、既存のプーラーはどれも、これらの性質の一部しか満たせていない。
PgSteward は何をするのか
要するに、PgSteward は、プールサイズを設定ファイルに書く値ではなく、需要に応じて配る予算として扱えるようにしたクラスタ型の PgBouncer である。 そのため、プーラーの台数やテナントを増やしても、プールサイズを計算し直す必要がないし、 データベースへの接続の合計は max_connections から求めた上限を超えず、各テナントにはあらかじめ宣言した最低限の接続数(最低保証)を守ったうえで残りを需要に応じて配れる。 しかも、クエリの経路にホップが増えないので、スループットは PgBouncer と同等を保てる。
具体的には、PgSteward はプールサイズの上限を設定値として持たず、1 箇所の台帳から需要に応じて払い出す。 台数やテナント数の増減だけであれば、総量を割り直す処理を自動化すれば対応できる。 しかし、需要の偏りや時間帯による入れ替わりには、割り算では追随できない。 需要に追随しつつ下限も守るためには、接続を張る前に枠を予約する必要がある。 先着順で張らせると、空きを取り切ったテナントの後では下限を守れないからである。 そして予約を受け付けるには、全体の割当を 1 箇所で持つ台帳が要る。
総予算を求める
払い出せるコネクションの総量をここでは総予算と呼ぶ。 PgSteward はこの総予算を設定ファイルに書かず、max_connections から、PostgreSQL が管理者用に予約している枠と、プーラー以外の接続元について観測した接続数の最大値を引いて求める。 そのため、人間が台数で割り算をする場面はなくなり、他の接続元のぶんは最初から総予算の外に置かれる。
また、接続数の上限の検査は、プーラー側に任せず PostgreSQL に行わせる。 具体的には、後述する proxy(プーラーの本体)はテナントごとのロールで接続を張り、後述する coordinator は各ロールの CONNECTION LIMIT(PostgreSQL がロールごとに許す同時接続数の上限)を、そのテナントへの払い出しの合計に合わせて書き換える。 各ロールの上限の合計は総予算以下に保つので、proxy が払い出しを超えて接続を張ろうとしても、その接続は接続時に PostgreSQL に拒否される。
最低保証と余剰を管理する
テナントには最低保証・上限・重みの 3 つを宣言させる。 PgSteward はこの宣言に基づいて最低保証を先に確保し、残った余剰を、需要のあるテナントへ重み付き max-min fair で配る。 max-min fair は、少なく要求しているテナントを先に満たし、余った分を多く要求しているテナントで分け合う方式である。 最低保証は API とバッチのように守りたい用途にだけ宣言すればよく、それ以外のテナントは最低保証 0 のまま余剰を分け合う。
例えば総予算 100 本、API を捌く web の最低保証 30 本、夜間バッチを走らせる worker の最低保証 10 本で、web が 60 本、worker が 90 本を要求したとする。 この場合、まず最低保証の 30 本と 10 本を確保し、余剰 60 本を残りの要求(web 30 本、worker 80 本)へ配ると、重みが等しければ各 30 本になる。 その結果、web は 60 本で要求を満たし、worker は 40 本になる。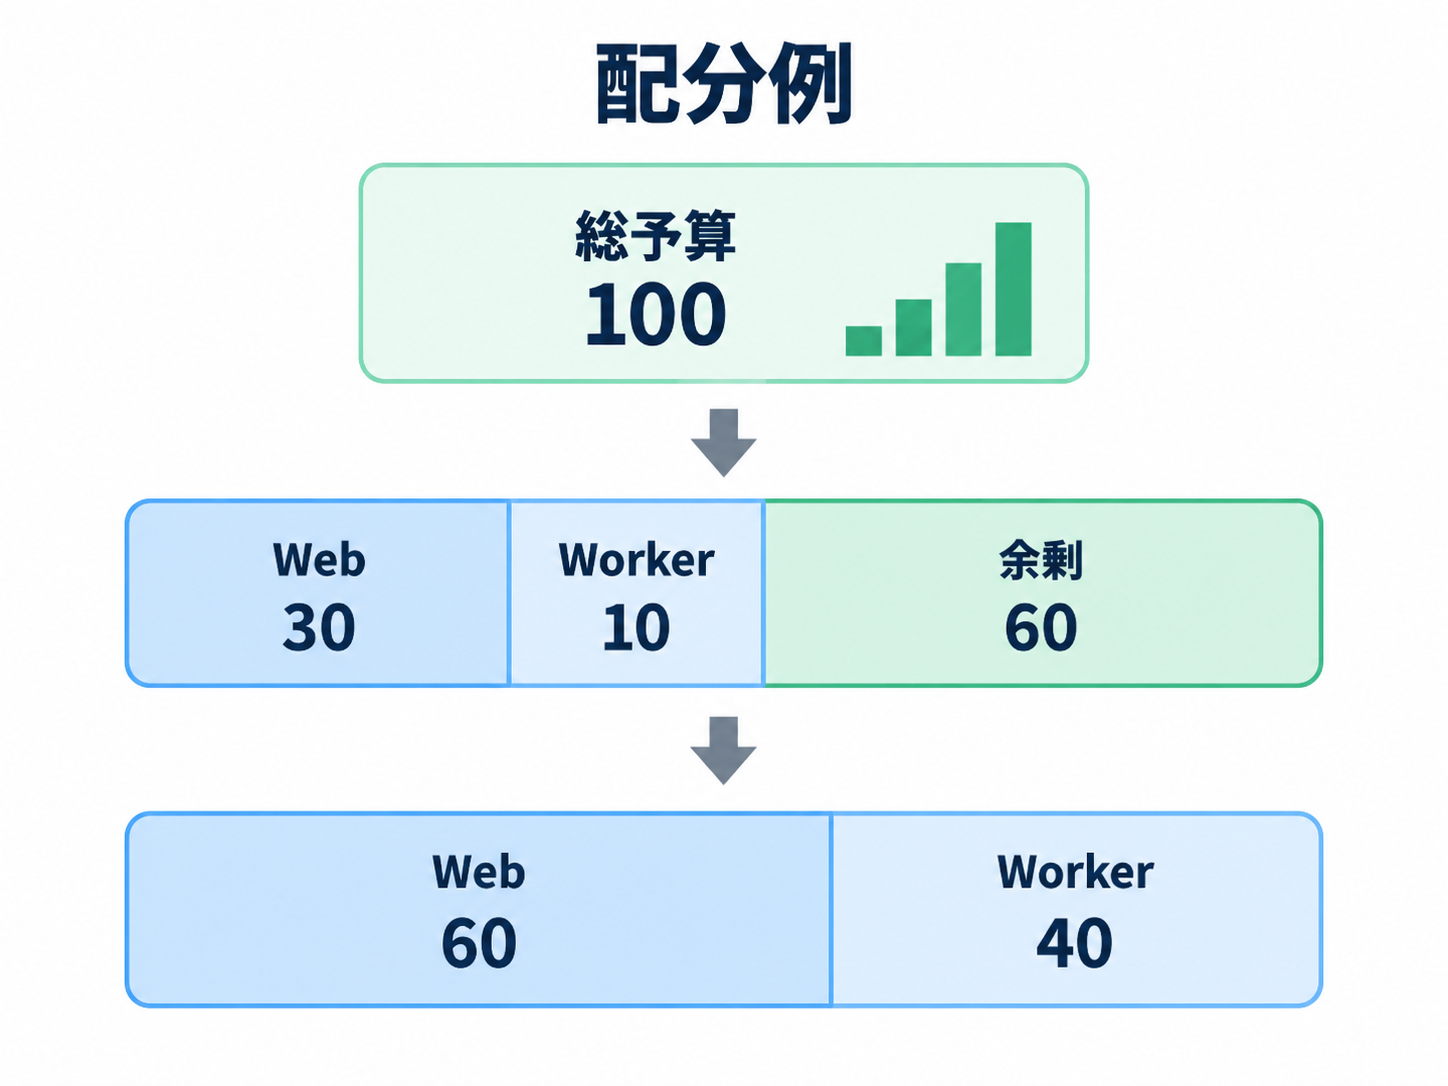
この配り方では、時間帯で需要が入れ替わると、払い出しもそれに合わせて変わる。 例えば、日中は worker の需要がないので、枠はほぼすべて web に渡る。 その後、夜間にバッチが始まると、枠は web から worker へ移る。 バッチの最中に API の需要が戻れば、上の例のとおり web は 60 本を得て、待つのは worker だけになる。 もちろん、総量が足りなければ誰かは待つことになる。 それでも PgSteward では、最低保証によって待つ側を選べる。
なお、払い出しは需要のあるテナントにしか行わないので、テナントを登録しただけではプールは作られない。 そのため、プールの数は、登録したテナントの数ではなく、同時にクエリを投げているテナントの数に比例する。
割当を決める coordinator とクエリを通す proxy
ただし、台帳を持つ主体をクエリの経路に置いてしまうと、割当を決めるための通信の遅延がそのままクエリの遅延に加わる。 そこで PgSteward は役割を 2 つに分けた。 このうち proxy はプーラーの本体で、アプリケーションからの接続を受け、データベースへ接続を張ってクエリを通す。 一方の coordinator は台帳を持ち、どの proxy がどのテナントのために何本張ってよいかを決める。 ただし、運用するものは増やしたくないので、両者は同じバイナリで、起動時の指定によって役割を切り替える。
  flowchart LR
    App["アプリケーション"] --> Proxy["proxy<br/>任意の台数"]
    Proxy ==>|"クエリ"| DB[("PostgreSQL")]
    Proxy -.->|"需要の報告"| Coord["coordinator<br/>割当表"]
    Coord -.->|"枠の払い出し・回収"| Proxy
    Coord -.->|"接続の確認・上限の書き換え"| DB
図の実線がデータの経路で、アプリケーション、proxy、PostgreSQL の 1 本道である。 このように、クエリとその応答は coordinator を通らないので、Supavisor のような中継のホップは増えない。
プーラーの台数が変わる場合も、払い出しは台数で割るのではなく需要で決まるので、proxy を 4 台から 8 台に増やしても総予算は 100 本のままで、設定は何も変えない。 さらに、200 台に 100 本を配る構成も、既存のプーラーでは 1 台あたり 0.5 本と書く必要があって表現できないが、PgSteward では需要のある proxy に枠を寄せる形で成立する。 ただし、全台が同時に需要を持てば全台に 1 本ずつは行き渡らず、枠を得られなかった proxy のクライアントは待たされてしまう。
coordinator が止まったとき
もし coordinator が止まったときにクエリまで止まるのであれば、固定値を書く既存のプーラーより可用性が悪くなってしまう。 そこで PgSteward では、coordinator が止まっても、すでに張られている接続でクエリが流れ続け、最低保証の範囲で新しい接続も張れる。 このとき PgSteward は、止まった時点の払い出しを上限とする固定上限のプーラーに縮退する。
また、coordinator が持つ割当表も、失われて困る状態にはしていない。 proxy ごと・テナントごとの実際の接続数は PostgreSQL の接続の一覧(pg_stat_activity)に表れるので、割当表はそこから組み立て直せるキャッシュとして扱う。 そのため、割当表のために別の複製の仕組みは持たず、coordinator が再起動しても接続の一覧を読み直せば元に戻る。
まとめ
プーラーの台数の増加、テナント数の増加、混雑時の取り分は、それぞれ別の場面で起きる問題である。 しかし、どれも有限のコネクションをどう配るかという問題であり、プールサイズを設定ファイルに書く静的な値として扱っていることが原因で解けなくなっていた。 そこで PgSteward は、プールサイズを 1 箇所の台帳から需要に応じて払い出す予算として扱う。 具体的には、総予算はデータベースから求め、守りたい用途には最低保証を宣言させ、余剰は需要のあるところへ配る。 そして、台帳を持つ coordinator はクエリの経路に置かず、止まっても固定上限のプーラーに縮退するだけでクエリは止まらない。
Jasraj Dange et al., Lakebase: Serverless Postgres over Open Lake Storage, PVLDB Vol. 19.
接続を分けて管理する利用者の単位を指す。SaaS の顧客ごとや、API とバッチのような用途ごとに分けるイメージである。